実機ロボットによる両腕操作を行うための、ロボティクス基盤モデルの事後学習 〜 RSS 2026 "Post-Training for Robotics Foundation Models Challenge" テクニカルレポート 〜
ロボティクス基盤モデルの事後学習をテーマとするコンペティション「Post-Training for Robotics Foundation Models Challenge」に、 当研究室から博士課程学生の阿部 陽樹さんと原 健宏さんが参加し、優勝を果たしました。 本コンペティションは、ロボティクス分野のトップカンファレンスの一つである RSS 2026 において開催されたものです。
この記事は、テクニカルレポートの抄訳です(一部は意訳しています)。詳細については、テクニカルレポートをご覧ください。
ポイント
- フェーズ1において、シングルタスク・トラックとマルチタスク・トラックの両方で1位となりました。
- 核となる部分のレシピ:(Vision-Language-Action の基盤モデルである)π0.5 の全ての重みをファインチューニングしました。フェーズ1ではグローバルなバッチサイズを128とし、フェーズ2では 256 として、使用できる全ての非失敗データを、データ型固有の損失の重み付けをすることなしに学習しています
- 得られた主な知見: Human-in-the-loop (HIL) リカバリデータとタスク固有のリセット除去が、我々の開発においては有用でした。汎用的なキュレーション手法も試み、評価してみましたが、大きな効果をもたらしませんでした。
概要
この記事では、RSS 2026 で開催された「Post-Training for Robotics Foundation Models Challenge」における、我々の解法について報告します。コンペティションの運営側から公式に提供されている π0.5 スタイルのアーキテクチャを維持し、入手可能な非失敗データすべてに均一な模倣学習損失を適用して、フルウェイト(すべての重み)に対するファインチューニングを行いました。
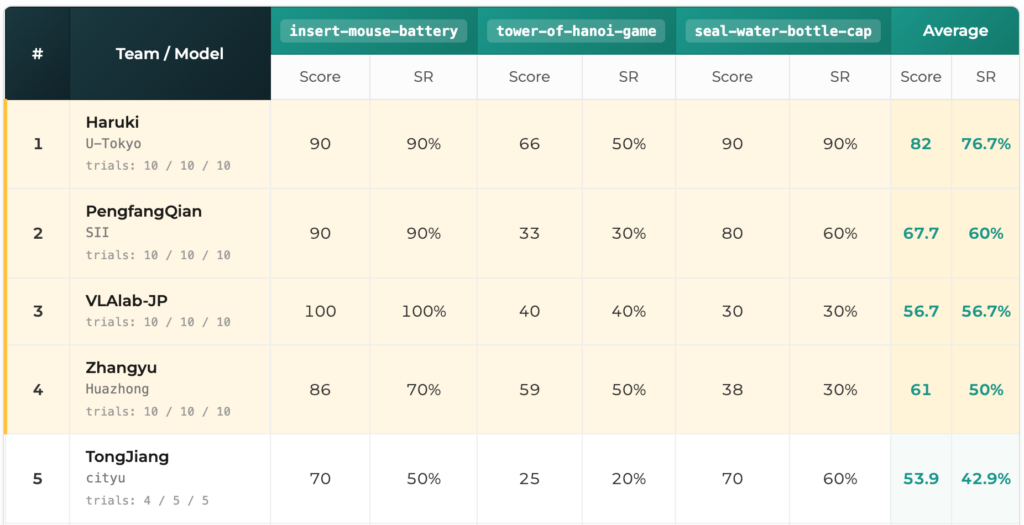
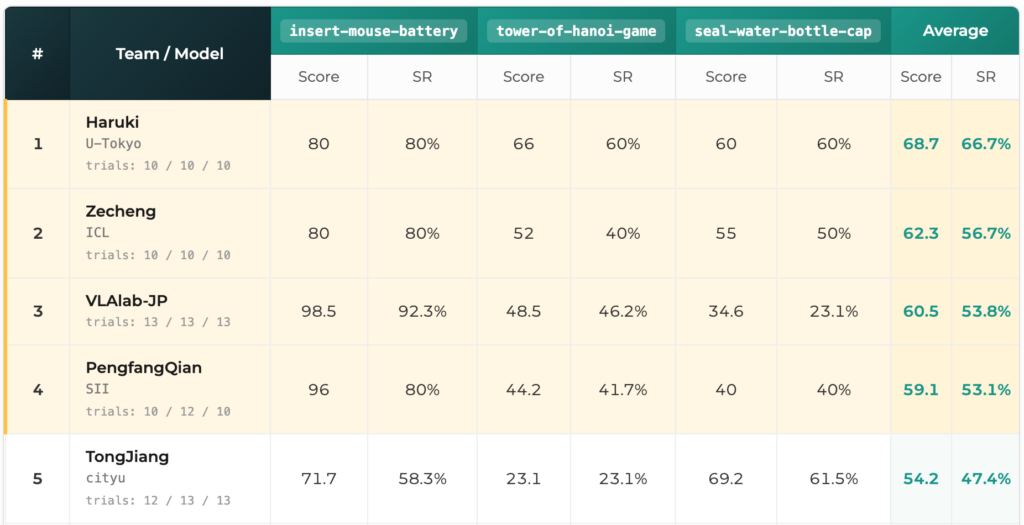
フェーズ1では、4つの80 GB NVIDIA A100 GPUを使用し、グローバルバッチサイズは128としました。私たちの提出内容は、シングルタスクとマルチタスクの両方のトラックで1位を獲得しました。コンペティション公式のpi05参照ポリシー [11] が示す性能が 60.3 (シングルタスク)と 52.3 (マルチタスク)であったのに対して、私たちの平均進捗スコアはそれぞれ82.0(シングルタスク)と68.7(マルチタスク)でした。Human-in-the-loop (HIL) によるリカバリを含んだデータと、タスク成功後のリセットセグメントの削除は有用でしたが、評価したキュレーション手法は、今回の条件下では大きな効果をもたらしませんでした。
フェーズ2では、80GBのA100 GPUを8基、グローバルバッチサイズを256として、フェーズ1のチェックポイントからフルウェイトのファインチューニングを継続し、リリース済みのロールアウトエピソード808件すべてを使用しました。seal-water-bottle-cap データには同じリセット削除を適用しましたが、insert-mouse-batteryポリシーについては、フェーズ2のトレーニングが提出前に完了しなかったため、変更しませんでした。フェーズ2の評価では、ジェネラリストポリシーの平均進捗スコアは67.3、スペシャリストポリシーの平均進捗スコアは74.3でした。
問題設定
問題設定と、コンペティションの「フェーズ」
このコンペティションは、事前学習済みのロボットのポリシーを、実際のインタラクションのデータをもちいてどのように改善できるかを明らかにすることを目的としています。ポリシーは、実機のロボットによる両腕操作タスクにおいて評価されます。このコンペティションは、2つのフェーズからなります。フェーズ1では、各チームは提供されたデータセットを用いてオフラインでの学習を行い、シングルタスクのそれぞれに最適化したポリシーと、マルチタスクのための共通ポリシーとを提出します。フェーズ1の上位3チームが、フェーズ2に参加し、運営側のサポートを受けながらデータ収集を行って、さらに学習を行ってポリシーを改善します。ランキングは、最初は平均成功率で評価され、タイブレイクにおいては平均進捗スコアが用いられます。
タスク
以下の3つのタスクが用いられました。公式ウェブサイトで動画が公開されています [1]。
| Task | Goal and progress scoring |
| insert-mouse-battery | マウスを正しい位置におき、電池を正しい向きで、すべて挿入します。進捗は、正しい位置になっているか、部分的に挿入できているかで評価されます。 |
| tower-of-hanoi-game | (論理パズル「ハノイの塔」をモチーフにしたもの)小さなリングを反対の杭に、大きなリングを真ん中の杭に、そして最後に小さなリングを大きなリングの上に載せます。途中までできていれば、部分点が与えられます。 |
| seal-water-bottle-cap | キャップ付きストローをボトルに入れ、キャップを置いて、締めます。完全に締めるまでは、回した数によって点数が増えます。 |
データセット
データセットについては、テクニカルレポート本文や、フェーズ1, 2 それぞれで提供されたデータセットのリンクを参照してください [2] [3]。
Phase 1 の結果
結果は平均進捗スコアで示されています。
| Track | Rank | Our average score | Official π0.5 baseline | Gain | Average success rate |
| Single-Task | 1st | 82.0 | 60.3 | +21.7 | 76.7% |
| Multi-Task | 1st | 68.7 | 52.3 | +16.4 | 66.7% |
以下のスクリーンショットは、公式ウェブサイトに掲載されているリーダーボードから取得したものです [11]。
手法の概要
新しいアーキテクチャを導入することはせず、コンペティションの運営側から公式に提供されている π0.5 スタイルのアーキテクチャを維持しました [4][5][6]。その上で、データの混合の仕方や、ファインチューニングの安定性、HIL リカバリデータ、そして seal-water-bottle-cap のリセット行動の除外などの工夫を行っています。
うまくいったこと
バッチサイズを大きくすること
我々は比較的大きなバッチサイズでの学習を実施しました。これは、不均質なロールアウトデータで学習する際に、より安定した学習を可能にするためです。学習に用いるデータには、エキスパートによるデモンストレーション、成功したロールアウト、HIL による修正、そしてタスクに特有な振る舞いなどが混合されたものであり、小さなバッチサイズでは重みを更新する際の分散が大きくなってしまいます。
コンペティションの公式から配布されたベースラインのバッチサイズは32であったのに対して、我々はフェーズ1で128、フェーズ2で256のバッチサイズとしました。それぞれ、ベースラインの4倍、8倍となっています。バッチサイズを大きくしたことは、有効に働きました。この設定は、RLDX-1 [7] や Heterogeneous Pre-trained Transformers (HPT) [8] など、先行研究を踏まえたものとなっています [9][10]。ただし、設定値は実験的に得られたものであって、必ずしも普遍性があるわけではありません。データセットやモデルのサイズ、学習率、そしてアクションの表現方式などによって変更する必要があります。
人間の介入によるリカバリ
人間が介入することでリカバリを行った際の振る舞いのデータは、現実的な失敗の後の振る舞いを含む際に、有用であることが分かりました。HIL は、単に「デモンストレーションの追加」ではなく、不完全なポリシーを補うものとして得られた場合に有用であることが示唆されています。
seal-water-bottle-cap におけるリセットの除去
元々の軌跡では、キャップを締めた後にリセットすることが行われていました。しかし、画像から「どのくらい締まっているのか」を判断することは困難です。キャップを締めるのを途中でやめたり、巻き戻してしまったりするように学習してしまうかもしれません。そこで、今回は、リセットを除去することにしました。これは汎用的なアプローチではなく、タスクや指標に則してアライメントを行ったものです。
得られた実践的知見
- 事後学習を強力に行う上で、基盤となる Vision-Language-Action モデルの変更は必ずしも必要ではない。
- 人間の介入によるリカバリのデータは、我々がモデルの事後学習を行う上で有用であった。
- 汎用的なデータのキュレーション手法も試してみたが、大きな性能向上は見られなかった。
- バッチサイズを大きくすることが、我々が行った事後学習では実用的だった。
フェーズ2の結果
フェーズ2では、コンペティションの運営側によるサポートのもとで、フェーズ1のポリシーを改良しました。オンポリシーのロールアウトを追加で収集し、事後学習のイテレーションを回しました。リリースされたロールアルとについては、Phase 2 のデータセットに詳細が記載されています [3]。
各タスクについて10回ずつの試行が評価されました。
| Policy | Iteration | Average progress score |
|---|---|---|
| Generalist | Iteration 3 | 67.3 |
| Specialists | Iteration 2 | 74.3 |
追加での学習を行いましたが、ジェネラリストポリシーは Phase 1 と比べて 1.4ポイント、スペシャリストポリシーは7.7ポイントの低下がありました。
将来課題
今後の研究では、私たちの混合データセットからは除外した「ベースラインが失敗したときの軌跡」を利用できるオフライン強化学習手法を検討したいと考えています。このような手法を用いることで、失敗の原因となった行動を直接模倣することなく、失敗したインタラクションから学習に有効なシグナルを抽出できる可能性があります。
謝辞
This work was partially supported by JST Moonshot R&D Grant Number JPMJPS2011. H.A. was supported by JST BOOST, Japan, Grant Number JPMJBS2418.
References
- Post-Training for Robotics Foundation Models Challenge website. https://posttraining-for-robotics.github.io/
- Post-Training for Robotics Foundation Models Challenge. Challenge Phase 1 Dataset. https://huggingface.co/datasets/Posttraining-RFM-RSS2026/Challenge-phase1-dataset
- Post-Training for Robotics Foundation Models Challenge. Challenge Phase 2 Rollouts Dataset. https://huggingface.co/datasets/Posttraining-RFM-RSS2026/Challenge-phase2-rollouts-dataset
- Post-Training for Robotics Foundation Models Challenge. OpenPI Baseline, commit 3cf4747fcc2d9b8023eb43b681b141f93527d65e. https://github.com/posttraining-for-robotics/openpi-baseline/tree/3cf4747fcc2d9b8023eb43b681b141f93527d65e
- Physical Intelligence. π0.5: a Vision-Language-Action Model with Open-World Generalization. arXiv:2504.16054. https://arxiv.org/abs/2504.16054
- Physical Intelligence OpenPI repository. Fine-tuning π0.5 examples. https://github.com/Physical-Intelligence/openpi
- Kim et al. RLDX-1 Technical Report. arXiv:2605.03269. Includes a batch-size ablation comparing global batch sizes 64, 256, and 1,024 on simulation benchmarks. https://arxiv.org/html/2605.03269v2
- Wang, L., Chen, X., Zhao, J., and He, K. Scaling Proprioceptive-Visual Learning with Heterogeneous Pre-trained Transformers. NeurIPS 2024. Paper PDF
- McCandlish et al. An Empirical Model of Large-Batch Training. arXiv:1812.06162. https://arxiv.org/abs/1812.06162
- Smith et al. Don’t Decay the Learning Rate, Increase the Batch Size. ICLR 2018. https://openreview.net/forum?id=B1Yy1BxCZ
- Post-Training for Robotics Foundation Models Challenge. Phase 1 leaderboard, website commit fc94bc171414584e22a956b4494a65b6c0e33341. https://github.com/posttraining-for-robotics/posttraining-for-robotics.github.io
