【論文紹介】Rethinking Policy Diversity in Ensemble Policy Gradient in Large-Scale Reinforcement Learning
ばらばらな探索から、協力する探索へ — 複数のAIが経験を共有する強化学習手法 —
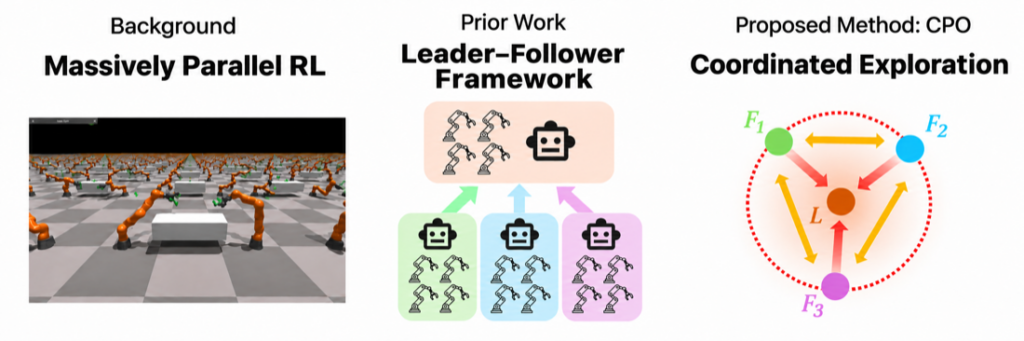
ロボットが物をつかんだり、指先で物体の向きを変えたりする動作を身につける方法の一つに、「強化学習」があります。これは、人間が何度も転びながら自転車に乗る方法を学ぶように、試行錯誤の結果をもとに、よりよい行動の選び方を学ぶ方法です。近年は、コンピュータ上で数万ものシミュレーション環境を同時に動かし、大量の経験からロボットを学習させられるようになりました。
では、たくさんのロボットに、どのように試行錯誤させればよいのでしょうか。人間が何かを学ぶときには、一人で練習するだけでなく、複数人で違う方法を試し、その経験から学ぶことがあります。ロボットの強化学習でも、複数のAIがそれぞれ異なる方法で探索し、集めた経験を共有することで、一つのAIだけでは見つけにくい動きや解決方法を学べると期待されます。
ただし、複数人で学ぶ場合も、各自がばらばらに取り組むことと、互いの経験を活かしながら協力することは同じではありません。AIでも、それぞれが違う探索をすれば、それだけで学習がうまく進むのでしょうか。それとも、集めた経験を活かせるように、探索の仕方を調整する必要があるのでしょうか。
私たちは、この問いを、複数のAIが集めた経験を一つのAIに集約する「リーダー・フォロワー方式」で調べました。そして、それぞれの探索をリーダーの学びにつなげる手法、Coupled Policy Optimization(CPO)を提案しました。異なる方法での探索を保ちながら、集めた経験を活かせる関係をつくる。これが、本研究で目指す「協力する探索」です。
本研究は、機械学習分野の国際会議である ICLR 2026 (The Fourteenth International Conference on Learning Representations) に採択され、ブラジルのリオデジャネイロで4月23日から27日まで開催された会議において発表されました。ICLRは、人工知能分野の中でも、特に深層学習の分野における最高峰の国際会議として知られています。
この記事では、著者の四反田 直樹(Naoki Shitanda)が、研究の背景と提案手法を紹介します。
この記事で紹介する論文
この記事では、以下の論文について紹介します。
Naoki Shitanda, Motoki Omura, Tatsuya Harada, Takayuki Osa.
Rethinking Policy Diversity in Ensemble Policy Gradient in Large-Scale Reinforcement Learning.
International Conference on Learning Representations (ICLR), 2026.
プロジェクトページでは、学習結果に加えて、学習中にAI同士の関係がどう変わるかを示す可視化も公開しています。
論文の概要
一つのAIの試行錯誤から、複数のAIによる探索へ
強化学習では、目標に近づく行動に「報酬」を与えます。例えば、ロボットハンドで物体の向きを変える課題なら、目標の向きに近づくほど高い報酬が得られるようにします。AIは、より多くの報酬を得られるように、状況に応じた行動の選び方を改善していきます。この行動の選び方を「方策」と呼びます。
学習を進めるには、今できる動きを繰り返すだけでなく、別の動きも試して、よりよい方法を探す必要があります。この過程が「探索」です。
GPUを使ったシミュレーションでは、多数のロボットを同時に動かして探索できます。しかし、すべてのロボットが同じ方策を使うと、試し方が似通い、探索が偏ることがあります。同時に動かすロボットの数を増やしても、それに見合った学習の改善が得られるとは限りません。
そこで、複数の異なる方策を使って経験を集める方法が考えられます。同じ課題に対して、それぞれの方策で少しずつ違う方法を試すことで、探索の幅を広げるのです。
本研究の基盤となるリーダー・フォロワー方式では、一つのリーダーと複数のフォロワーが、それぞれの方策で探索します。フォロワーは自分の経験から学び、リーダーは自分の経験に加え、フォロワーの経験も取り入れます。複数の方策による試行錯誤を、一つの方策の改善につなげる仕組みです。
本研究のアプローチと提案手法
ばらばらに探索するだけでは、集めた経験を活かしきれない
人間同士で経験を共有するときも、相手のやり方をそのまま取り入れられるとは限りません。自転車の練習なら、すでに速く走れる人と、まだバランスを取る練習をしている人では、役に立つ経験や助言が違うでしょう。
強化学習でも、他の方策で集めた経験を、自分の方策で集めた経験とまったく同じように扱うことはできません。同じ状況でも、ある方策ではよく選ばれる行動が、別の方策ではほとんど選ばれないことがあるためです。
リーダーがフォロワーの経験から学ぶ際には、こうした違いに応じて、経験の重みを補正します。しかし、方策が離れすぎると、経験の重みに大きな偏りが生まれます。大量の経験を集めても、学習が一部のデータに強く左右されたり、学習を安定させるための処理によって情報を十分に利用できなくなったりします。
本研究では、この問題を理論的に分析しました。注目したのは、重みの偏りを考慮したデータの実質的な量を表す「有効サンプルサイズ」と、学習を安定させるために重みを制限する処理が生む偏りです。理論と実験の両面からの分析により、方策同士の隔たりを抑えることが、経験を有効に利用し、安定して学ぶための手がかりになると考えました。
つまり、探索の幅を広げることに加えて、集めた経験を学習に活かせる関係を保つことが重要なのです。
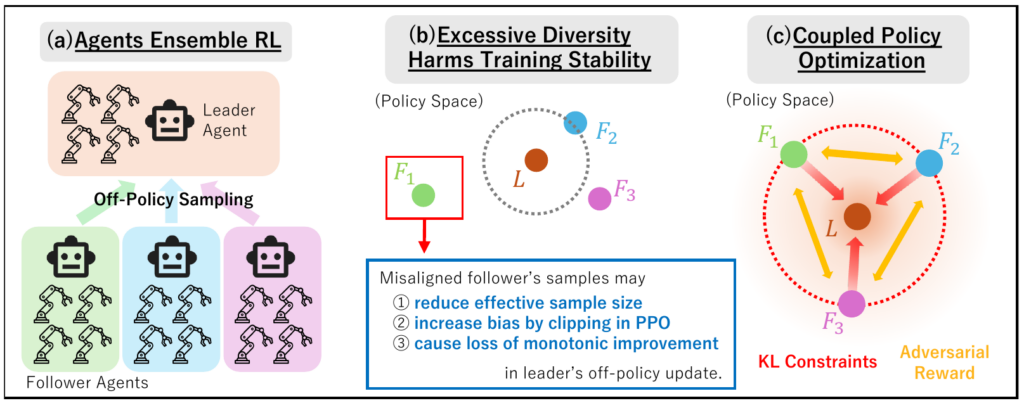
図1:複数のフォロワーの経験をリーダーに集める仕組みと、CPOの考え方。(a) は経験の集約、(b) は方策が離れすぎた状態が学習の安定性を損ねること、(c) はCPOによって隔たりを調整した状態を示す。図中の距離は、方策、すなわち行動の選び方の違いを表している。
CPO:フォロワーそれぞれの探索を、リーダーの学びにつなげる
私たちが提案する Coupled Policy Optimization(CPO)は、フォロワーが自分の課題を学習すると同時に、リーダーから離れすぎないように方策を調整する手法です。
方策の隔たりを測るために、確率分布の違いを表す「KLダイバージェンス」という指標を使います。ここでは、同じ状況で二つの方策がどれくらい異なる行動を選ぶかを測るものと考えてください。CPOは、この隔たりに制約を設けるようにフォロワーの学習を組み立てます。
これによって、フォロワーは新しい行動を試しながら、リーダーにとっても利用しやすい経験を集められます。また、フォロワーの更新にはリーダーの経験も使われます。フォロワーの探索をリーダーが取り込み、そのリーダーを参照しながらフォロワーも学ぶ、という関係ができます。
ここでいう「協力」とは、それぞれの方策で異なる探索を続けながら、その経験が学習につながるように、方策同士の関係を調整することです。
さらに、方策が似通いすぎることを防ぐ仕組みとして、フォロワーごとの特徴が表れる行動に補助的な報酬を与えます。これは、状況と行動から「どの方策で集めた経験か」を判別するモデルを使ったものです。ただし、実験では、この補助報酬を外しても性能差が小さい場合がありました。今回の改善の中心は、リーダーとフォロワーの隔たりを調整するKL制約にあります。
実験設定と結果
ロボットの物体操作のシミュレーション課題で、高い学習効率を確認
CPOの効果を調べるため、多指ハンドでの物体操作、グリッパーによる物体操作、歩行を含む、計10種類のシミュレーション課題で実験しました。24,576個の環境を並列に動かし、CPOでは一つのリーダーと五つのフォロワーを学習させました。
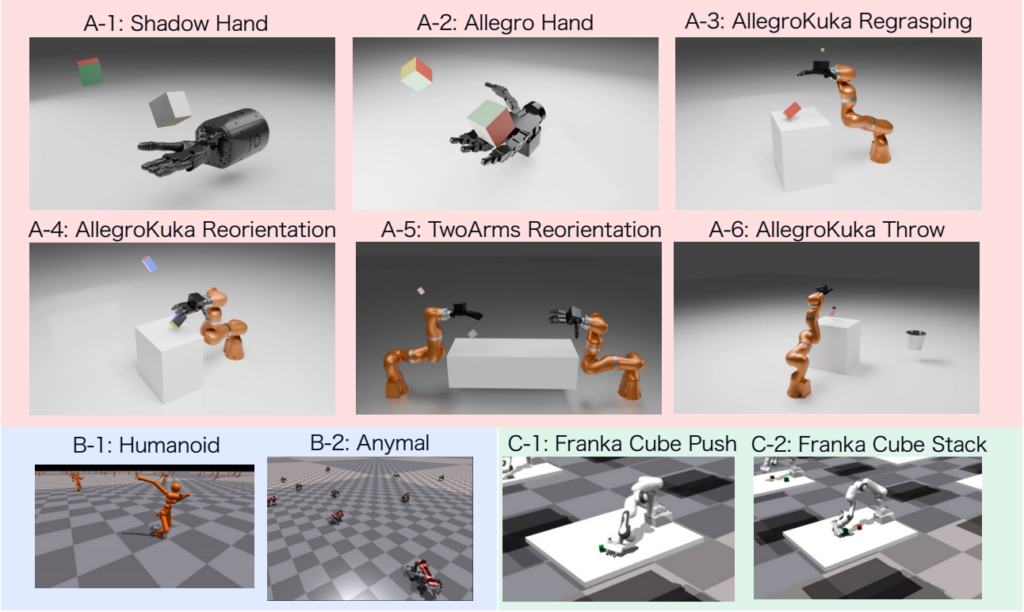
図2:実験で用いた10種類のシミュレーション課題。上段のピンク色の領域には、指先での物体の向きの変更や持ち替え、両腕での操作、投げる動作などの6課題が含まれる。これらの多指ハンド物体操作タスクの画像の一部は、SAPGのプロジェクトページより引用している。下段左の青色の領域は二足・四足歩行の2課題、右の緑色の領域はグリッパーで物体を押す・積み上げる2課題。
比較したのは、広く使われる強化学習手法PPO、複数の方策を並列に学習させるDexPBT、そしてCPOの基盤となるリーダー・フォロワー方式のSAPGです。
CPOは、特に複雑な物体操作で高い学習効率を示しました。例えば、手のひらの中で物体の向きを変える課題(ShadowHand, AllegroHand)や、片腕もしくは両腕で物体を指定の座標・向きに運ぶ課題(AllegroKuka Reorientation, Two-arms Reorientation)では、従来手法よりも学習が進み、最終的な性能も向上しました。複数の課題で、SAPGの最終性能に、およそ半分の環境ステップ数で到達しています。環境ステップ数は、シミュレーション内で行動して次の状態に移る回数で、試行錯誤の量を表します。

図3:10種類の課題における学習曲線。横軸は試行錯誤の量、縦軸は課題に応じた報酬またはエピソード内の成功回数を示す。赤線がCPOで、線と帯は5回の実験の平均と標準偏差を表す。少ない試行で高い性能に達するほど、効率よく学習できていると言える。
一方、効果は課題によって異なります。片腕で物体を指定の位置に運ぶ課題(AllegroKuka Regrasping)や投げる課題(Throw)では、SAPGに対する有意な性能向上は見られませんでした。また、歩行課題では手法間の差が比較的小さく、DexPBTが速く学習する場合もありました。
この違いを理解するために、学習中の方策同士の関係も調べました。CPOが明確に改善した課題では、SAPGの一部のフォロワーがリーダーから大きく離れていた一方、CPOではその隔たりが抑えられていました。SAPGとCPOの性能が近かったAllegroKuka Regraspingでは、SAPGでも大きな隔たりは見られませんでした。

図4:学習中の方策間の隔たり。各マスの色は、二つの方策のKLダイバージェンスを表し、紫ほど小さく、黄色ほど大きいことを示す。Lはリーダー、F1〜F5はフォロワーで、白い丸は各フォロワーから見て最も近い別の方策を示す。上から順に50億、100億、150億環境ステップ時点の比較。CPOでは、各フォロワーにとってリーダーが最も近い方策になる関係が観察された。
CPOでは、経験の重みの偏りが小さくなり、有効サンプルサイズも改善しました。これらの結果は、方策同士の関係を調整することで、フォロワーが集めた経験をリーダーの学習に活かしやすくなることを示しています。
今後の展望
ばらばらな探索から、協力する探索へ
複数の方策を使う強みは、それぞれが異なる経験を集められることにあります。しかし、経験を持ち寄るだけでは、その強みを十分に活かせない場合があります。本研究では、行動の選び方の違いを適切に調整することで、多様な探索を、より安定した効率のよい学習につなげられることを示しました。
今回の実験では、方策の数と、それぞれに割り当てるシミュレーション環境の数を固定しました。しかし、必要な探索の広さは、課題や学習の進み具合によって変わるはずです。今後は、こうした数や割り当てを自動的に調整し、複数の方策による探索をさらに効果的にする方法を検討したいと考えています。
複数の方策を協調的に学習することで、より効率的で器用なスキルの学習を実現する。このような学習の仕組みが、将来、複雑な動作を身につけるロボットの開発を支えると期待しています。
